Algorithme de Dijkstra
- François Brucker
L'algorithme de Dijkstra permet, à partir d'un graphe orienté valué positivement, de trouver un chemin de longueur minimum entre deux sommets $d$ (départ) et $a$ (arrivée). Il cherche à créer un arborescence à partir d'un graphe initial $G$. Précisons cela.
Définition
Soit $G =(V, E)$ un graphe orienté, $f$ une valuation positive des arcs de $G$ et $x$ un sommet du graphe. Une arborescence $T_{x} = (V', E')$ est un graphe tel que :
- $x \in V'$
- $V' \subseteq V$ et $E' \subseteq E$
- il existe un chemin $c^T_{xy}$ unique entre $x$ et $y$ dans $T_{x}$ pour tout sommet $y \in V'$
- pour tout $y \in V'$, tout chemin $c^G_{xy}$ entre $x$ et $y$ dans $G$ est tel que $f(c^G_{xy}) \geq f(c^T_{xy})$ : le chemin dans $T_x$ est minimum
Par exemple :
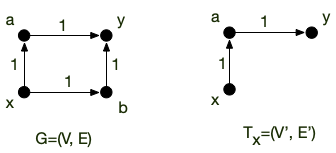
La définition d'une arborescence garantit le fait que tout ses chemins sont de poids minimum pour $G$. Remarquez de plus que pour tout graphe orienté $G$, il existe au moins une arborescence pour chacun de ses sommets puisque $T_{x} = (\{x\}, \varnothing)$ en est une quelque soient $x$ et $G$.
Enfin, la proposition suivant montre que l'on peut faire grossir les arborescences :
Proposition
Soit $G =(V, E)$ un graphe orienté valué par une fonction positive $f$. Et $T_x = (V', E')$ une de ses arborescence.
Si :
$$ W = \{ uv \mid uv \in E, u \in V', v \in V \backslash V' \} $$
N'est pas vide alors il existe un arc $u^\star v^\star \in W$ tel que :
$$f(c^T_{xu}) + f(u^\star v^\star) = \min_{uv \in W}(f(c^T_{xu}) + f(uv))$$
Et
$$ T' = (V' \cup \{v^\star\}, E' \cup \{ u^\star v^\star \}) $$
est également une arborescence de $G$
preuve
preuve
Comme on ne rajoute qu'un arc à $E'$ pour créer $E''$, il ne peut exister qu'un seul chemin pour aller de $x$ à un autre sommet $y$ de $G'' =(V'', E'')$.
Il nous reste à prouver que le chemin pour aller de $x$ à $v^\star$ dans $G''$ est bien un chemin de poids minimum dans $G$. Pour cela, supposons qu'il existe un autre chemin entre $x$ et $v^\star$ dans $G$. Comme $x \in V''$, on peut noter $w$ le premier sommet de ce chemin qui n'est pas dans $V'$. Comme $w \neq v^\star$ (sinon les deux chemins seraient identiques) on se retrouve dans le cas de la figure ci-dessous :
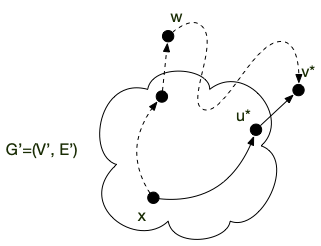
Le poids du chemin en pointillé de $x$ à $w$ est par construction plus grand que le poids du chemin allant de $x$ à $v^\star$ (en trait plein). Comme les poids sont positifs, le chemin en pointillé de $x$ à $v^\star$ est donc de poids supérieur à celui en trait plein.
Le principe de l'algorithme de Dijkstra qui cherche un plus court chemin entre deux sommets $x$ et $y$ d'un graphe orienté valué par une fonction positive $f$ est alors :
- partir de l’arborescence $T_{x} = (\{x\}, \varnothing)$
- tant que $W = \{ uv \mid uv \in E, u \in V', v \in V \backslash V' \}$ est non vide faire grossir l’arborescence
- si le dernier sommet ajouté est $y$, l'algorithme s'arrête et rend le chemin entre $x$ et $y$ dans l'arborescence
Ne confondez pas Prim et Dijkstra :
- Quelle est la différence entre Prim et Dijkstra ?
- Montrez que les problèmes qu'ils résolvent sont différents et en déduire que l'arborescence obtenue par l'algorithme de Dijkstra pour un graphe non orienté peut être différente de l'arbre de poids minimum obtenu par Prim
solution
solution
Le graphe suivant montre que l'arborescence de Dijkstra sera différente de l'arbre de poids minimum donné par Prim.
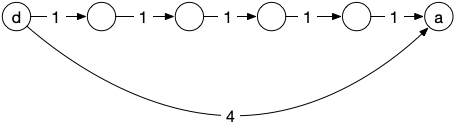
Ne confondez pas les 2 problèmes !
L'implémentation naïve de cet algorithme serait cependant d'une complexité importante car on recalculerait trop souvent les mêmes choses.
Implémentation
L'idée de l'algorithme de Dijkstra est d'implémenter le principe précédent de façon optimale.
Pseudo-code
On cherche à trouver un plus court chemin entre deux sommets, nommées départ et arrivé, d'un graphe orienté $G$ valué par une fonction positive $f$.
Entrées :
    Un graphe G=(V,E)
    une fonction de coût f positive

Initialisation :
    prédécesseur[départ] = départ  # pour retrouver les chemins

    coût[départ] = 0  # distances
    coût[u] = +∞ pour tous les autres sommets u

    V_dijkstra = {départ}  # les sommets de l'arborescence

    pivot = départ  # pivot est le dernier élément ajouté à l'arborescence

Algorithme :
    tant que pivot ≠ arrivé :
        # mise à jour des coûts
        pour tous les voisins x de pivot dans G qui ne sont pas dans V_dijkstra :
            si coût[x] > coût[pivot] + f(pivot, x):
                coût[x] = coût[pivot] + f(pivot, x)
                prédécesseur[x] = pivot

        # ajout d'un élément à la structure
        soit u un élément de V \ V_dijkstra tel que coût[u] soit minimum

        pivot = u
        ajoute pivot à V_dijkstra


    # restitution du chemin (pivot = arrivé au départ)
    chemin = []
    x = pivot
    tant que x ≠ départ:
        ajoute x au début de chemin
        x = prédécesseur[x]

Retour :
    chemin
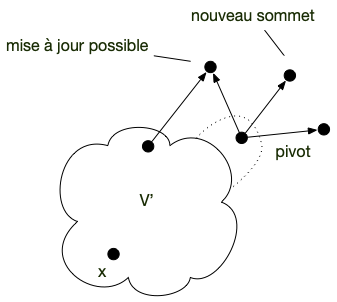
A chaque étape on ajoute un nouveau sommet de la frontière (un sommet dont le coût est non infini, c'est à dire un sommet $y \notin V'$ tel qu'il existe $x \in V'$ et $xy \in E$) à la structure que l'on appelle pivot
L'astuce est de voir que si l'on stocke les coûts, on a uniquement besoin de les mettre à jour lorsque l'on ajoute un nouveau sommet dans la structure :
Python
Une implémentation en python en utilisant le codage par dictionnaire des graphes et une valuation également codée par un dictionnaire dont les clés sont les arcs et les valeurs la valuation est donnée ci-après :
def dijkstra(G, f, départ, arrivé):
    prédécesseur = {départ: départ}
    coût = {départ: 0}
    V_dijkstra = {départ}

    pivot = départ
    while pivot != arrivé:
        for x in G[pivot]:
            if x in V_dijkstra:
                continue

            if (x not in coût) or (
                coût[x] > coût[pivot] + f[(pivot, x)]
            ):
                coût[x] = coût[pivot] + f[(pivot, x)]
                prédécesseur[x] = pivot

        new = None
        for x in G:
            if (x in V_dijkstra) or (x not in coût):
                continue

            if (new is None) or (coût[new] > coût[x]):
                new = x

        pivot = new
        V_dijkstra.add(pivot)

    chemin = [arrivé]
    x = arrivé
    while x != départ:
        x = prédécesseur[x]
        chemin.append(x)
    chemin.reverse()

    return chemin
L'algorithme précédent peut être décomposé en plusieurs parties :
- initialisation (lignes 2 à 4) :
prédécesseuretcoût_entréesont des dictionnaires etV_dijkstraun ensemble - boucle principale, qui correspond au
while(lignes 6 à 27). Cette boucle est composée de deux parties :- mise à jour (lignes 8 à 16) : on considère tous les voisins de
pivotqui ne sont pas encore dansV_dijkstra(test des lignes 9 et 10) et on les met à jour si nécessaire (lignes 12 à 16) : soit on les découvre pour la première fois (x not in coût_entrée) soit on à mieux (coût_entrée[x] > coût_entrée[pivot] + f[(pivot, x)]) - recherche d'un nouveau
pivot(lignes 18 à 27) : on choisit un sommet non encore examiné de coût d'entrée le plus faible - la boucle principale s'arrête une fois que l'on choisi l'arrivé comme
pivot
- mise à jour (lignes 8 à 16) : on considère tous les voisins de
- construction du chemin (lignes 29 à 34) : on remonte de prédécesseur en prédécesseur en partant de
arrivéjusqu'à remonter endépart.
Déroulement de l'algorithme
Avant de voir comment il fonctionne, testez le. Le graphe ci-après représente les différents vols et leurs durées entre différentes villes d'Europe :
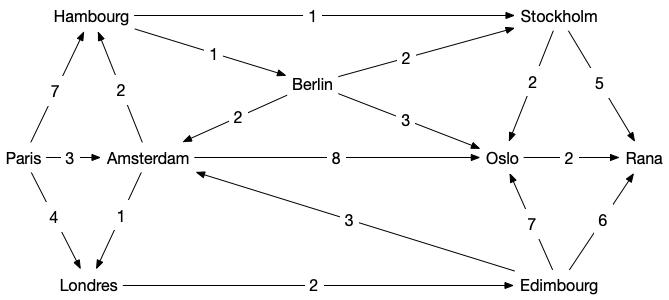
Le codage en python est alors le suivant pour le graphe :
G = {
    "Paris": {"Hambourg", "Amsterdam", "Londres"},
    "Hambourg": {"Stockholm", "Berlin"},
    "Amsterdam": {"Hambourg", "Oslo", "Londres"},
    "Londres": {"Édimbourg"},
    "Stockholm": {"Oslo", "Rana"},
    "Berlin": {"Stockholm", "Amsterdam", "Oslo"},
    "Oslo": {"Rana"},
    "Édimbourg": {"Amsterdam", "Oslo", "Rana"},
    "Rana": set(),
}
Et la fonction de valuation positive :
f = {
    ("Paris", "Londres"): 4,
    ("Paris", "Amsterdam"): 3,
    ("Paris", "Hambourg"): 7,
    ("Hambourg", "Stockholm"): 1,
    ("Hambourg", "Berlin"): 1,
    ("Amsterdam", "Londres"): 1,
    ("Amsterdam", "Hambourg"): 2,
    ("Amsterdam", "Oslo"): 8,
    ("Londres", "Édimbourg"): 2,
    ("Stockholm", "Rana"): 5,
    ("Stockholm", "Oslo"): 2,
    ("Berlin", "Stockholm"): 2,
    ("Berlin", "Amsterdam"): 2,
    ("Berlin", "Oslo"): 3,
    ("Oslo", "Rana"): 2,
    ("Édimbourg", "Rana"): 6,
    ("Édimbourg", "Amsterdam"): 3,
    ("Édimbourg", "Oslo"): 7,
}
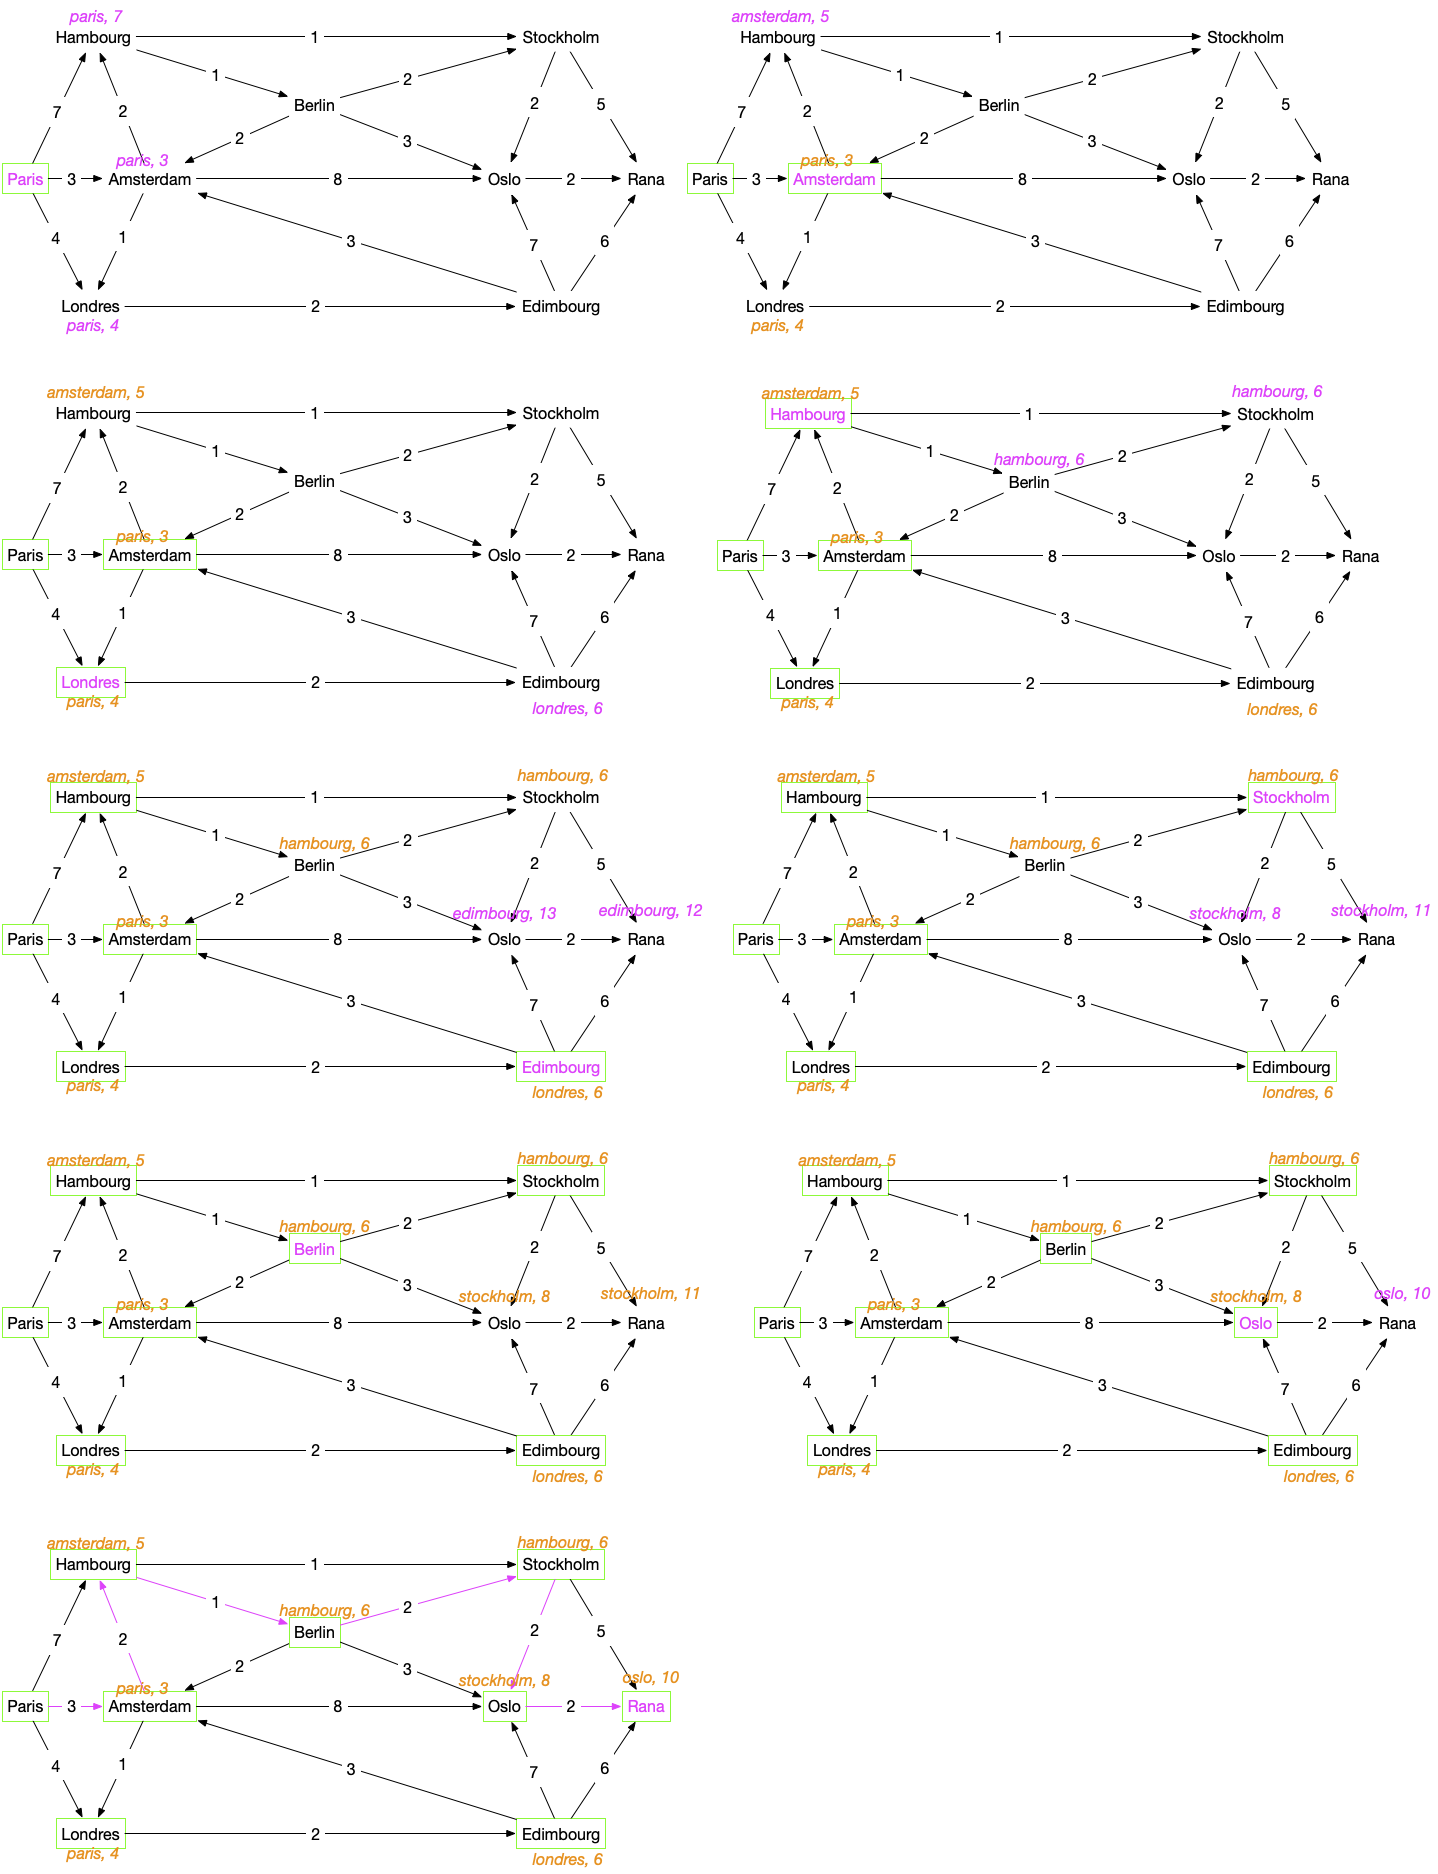
Faites un déroulé séquentiel de l'algorithme. Dans quel ordre les sommets sont-ils ajoutés dans V_dijkstra ?
solution
solution
Les différentes étapes de l'algorithme sont représentées dans les graphes ci-dessous.
- La figure se lit de gauche à droite et de haut en bas.
- les sommets de
V_dijkstrasont encadrés en vert - en orange les valeurs de
prédécesseuret decoût_entrée - en magenta
pivotet les modifications deprédécesseuret decoût_entrées'il y en a
Preuve
Proposition
Pour un graphe orienté valué positivement $(G, f)$ et deux sommet $a$ et $b$ de $G$, l'algorithme de Dijkstra rend un chemin élémentaire de longueur minimum entre $a$ et $b$ (s'il existe).
solution
solution
On montre par récurrence qu'à chaque étape le chemin de départ à pivot constitué en remontant les prédécesseurs de pivot jusqu'à arriver à départ est de longueur minimale et de coût coût_entrée[pivot].
Au départ pivot = départ, la propriété est donc vraie. On la suppose vrai jusqu'à l'itération $i$ (qui correspond au fait que l'on ait $i$ sommets dans V_dijkstra). A l'étape $i+1$, on a choisi pivot qui minimise le coût d'entrée parmi tous les sommets qui ne sont pas encore dans V_dijkstra.
Comme tous les chemins alternatifs entre départ et pivot commencent en départ, il existe un arc de ce chemin dont le départ (disons $u$) est dans V_dijkstra et l'arrivée (disons $v$) n'y est pas. Prenons la première arête $uv$ pour laquelle ça arrive.
Par hypothèse de récurrence, coût_entree[u] est le coût minimum d'un chemin entre départ et $u$ et coût_entree[v] est donc plus grand que coût_entree[u] + f[uv] (on a examiné ce cas lorsque l'on a fait rentrer $u$ dans V_dijkstra) et de coût_entree[pivot] (car c'est le min).
De là, le coût du chemin alternatif est plus grand également que coût_entree[pivot] car toutes les valuations sont positives : notre hypothèse est vérifiée.
Complexité
Proposition
La complexité de l'algorithme de Dijkstra est en $\mathcal{O}(\vert E\vert + (\vert V \vert)^2)$
preuve
preuve
On ajoute à chaque étape un élément, donc il y a au pire $\vert V \vert$ étapes. A chaque choix on compare les voisins de pivot. Ces comparaisons sont donc de l'ordre de $\mathcal{O}(\delta(\mbox{pivot}))$ opérations. Comme pivot est différent à chaque étape, toutes ces comparaisons sont de l'ordre de $\mathcal{O}(\sum\delta(\mbox{pivot})) = \mathcal{O}(\vert E \vert)$ opérations.
On prend ensuite le minimum parmi les éléments de V_dijkstra, ce qui prend $\mathcal{O}(\vert V \vert)$ opérations.
La complexité totale est alors en :
\[ \mathcal{O}(\underbracket{\vert E\vert}_{\mbox{mises à jour du coût d'entrée}} + \underbracket{(\vert V \vert)^2}_{\vert V \vert \mbox{ choix de pivot}}) \] <\p>
Corollaire
En déduire que la complexité de l'algorithme de Dijkstra est en $\mathcal{O}(\vert V \vert^2)$
preuve
preuve
Clair puisque $\vert E \vert \leq \vert V \vert)^2$.
On le voit dans la preuve de la proposition, le facteur limitant est la partie en $\mathcal{O}(\vert V \vert^2)$ qui n'est pas linéaire en la taille du graphe (en mémoire un graphe occupe de l'ordre de $\mathcal{O}(\vert E \vert + \vert V \vert)$ cases). Celle ci concerne le choix du nouveau pivot en cherchant un minimum de coût_entree. En optimisant cette opération, on peut drastiquement diminuer la complexité de l'algorithme.
Une optimisation classique est d'utiliser un tas pour trouver le min. On a alors que :
- une complexité de $\mathcal{O}(1)$ pour prendre un minimum
- une complexité de $\mathcal{O}(\log_2(M))$ où $M$ est le nombre d'éléments du tas pour mettre à jour la structure après chaque modification. Comme il va y a voir au maximum $V$ éléments dans ce tas, on peut borner cette complexité par $\mathcal{O}(\log_2(\vert V \vert))$
Enfin :
- il y a de l'ordre de $\mathcal{O}(\vert V \vert)$ prise de minimum : à chaque choix de
pivot - il y a de l'ordre de $\mathcal{O}(\vert E \vert)$ modifications : à chaque modification de
coût_entree
On a donc une complexité de choix de pivot qui passe alors de $\mathcal{O}(\vert V \vert^2)$ à $\mathcal{O}(\vert E \vert \log_2(\vert V \vert))$.
- S'il y a peu d'arcs, disons $\vert E \vert = \mathcal{O}(\vert V \vert)$, c'est beaucoup mieux puisque l'on a alors une complexité de : $\mathcal{O}((\vert V \vert)\log_2(\vert V \vert))$
- S'il y a beaucoup d'arcs, disons $\vert E \vert = \mathcal{O}(\vert V \vert^2)$, c'est un peu moins bon puisque l'on a alors une complexité de : $\mathcal{O}((\vert V \vert)^2\log_2(\vert V \vert))$
La complexité de Dijkstra avec un tas est alors : $\mathcal{O}(\vert E \vert + (\vert E \vert + \vert V \vert)\log_2(\vert V \vert))$ ce qui est égal à $\mathcal{O}((\vert E \vert + \vert V \vert)\log_2(\vert V \vert))$ qui est beaucoup mieux que l'implémentation naïve si le graphe est peu dense et un peu moins bonne dans le cas où le graphe est dense.
Il faut souvent en algorithmie choisir l'algorithme ou l'implémentation de l'algorithme en fonction des données que l'on aura à traiter. Il n'y a que très rarement des solutions meilleurs dans tous les cas.
Comme souvent les graphes sont peu dense lorsque l'on cherche un chemin de poids min — pensez à google maps où il y a bien peu de routes par rapport aux nombre d'endroit où l'on peu aller — on utilise souvent cette implémentation.
La page wikipédia précise qu'en utilisant un tas amélioré, dit tas de Fibonacci, on arrive même à faire descendre la complexité totale à $\mathcal{O}(\vert E \vert + \vert V \vert\log_2(\vert V \vert))$, ce qui est du coup tout le temps mieux que la prise de minimum naïve, mais nécessite une structure bien plus compliquée.
Arborescence
On peut continuer l'algorithme de Dijkstra après que $y$ ait été rentré dans V_dijkstra et s'arrêter lorsque l'on a plus que des éléments de coût infini à faire rentrer dans V_dijkstra ou que V_dijkstra soit égal à $V$.
Montrez que pour tous les sommets $x$ qui ne peuvent pas entrer dans V_dijkstra, il n'existe pas de chemin entre départ et $x$ dans $G$
solution
solution
A chaque fois que l'on ajoute un élément dans V_dijkstra on vérifie tous ses voisins pour mettre à jour le coût d'entrée dans la structure. On procède comme le parcours en largeur et on a montré qu'il trouvait la composante connexe de sa racine.
Montrez que si l'on peut continuer l'algorithme de Dijkstra jusqu'à ce que $V'$ soit égal à $V$ on obtient un graphe $G' = (V, E')$ tel que :
- $\vert E' \vert = \vert V \vert -1$
- il existe un unique chemin entre $d$ et tout autre sommet
- le chemin entre $d$ et $x$ dans $G'$ est de poids minimum dans $G$
solution
solution
Cette preuve dérive directement de la preuve de l'algorithme de Dijkstra que l'on a fait précédemment.
Dijkstra et BFS
TBD montrer que Dijkstra = BFS + file de priorité TBD attention différent de Prim dans ses valuations
Chemin de poids minimum n'est pas équivalent à chemin de poids maximum
Penser que renverser les inégalités dans l'algorithme de Dijkstra (de rentrer dans la structure à chaque fois l'élément de plus grand coût), permet de trouver un chemin le plus long est une faute.
Donnons un exemple. Le graphe suivant avec une valuation de 1 sur tous les arc :
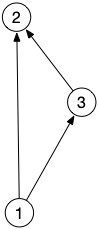
Le chemin de longueur maximum entre $1$ et $2$ est $132$. L'algorithme où l'on renverse toutes les inégalités trouvera ce chemin si les sommets sont examinés dans l'ordre $1$, $3$ puis $2$, mais il ne le trouvera pas si les sommets sont rentrés dans V_dijkstra dans l'ordre 1, 2, 3 (ce qui est possible).
Même s'il existe des cas où l'algorithme de Dijkstra trouvera le chemin le plus long, il en existe d'autres où il ne le trouvera pas...